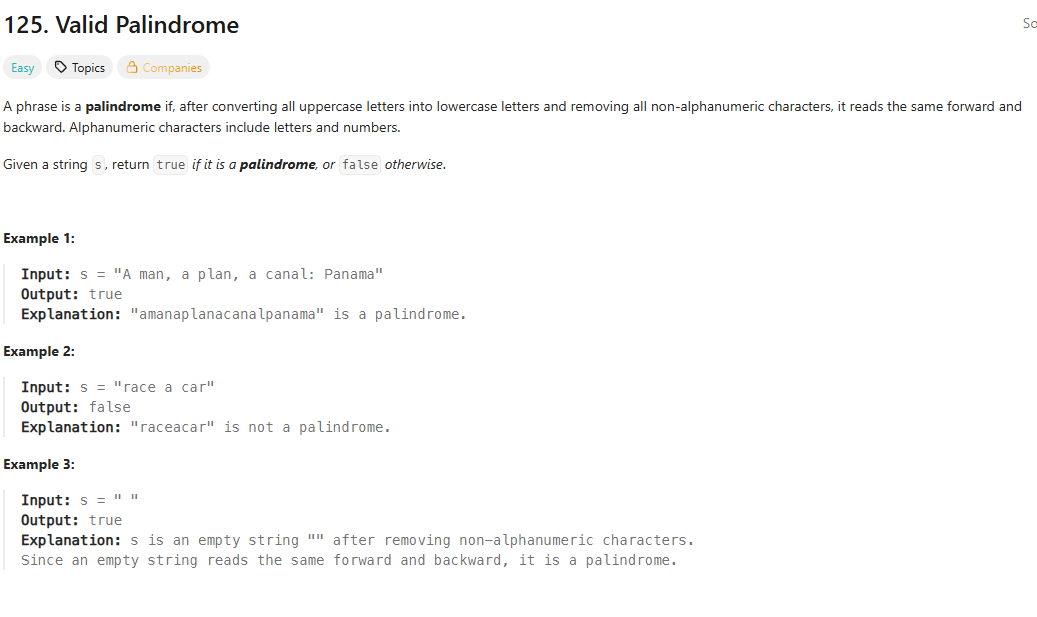
📌 한 줄 요약 영문자·숫자만 남긴 소문자 문자열을 만들고, 양 끝에서 안쪽으로 짝지어 비교한다(투 포인터). 정리 단계를 없애고 포인터로 건너뛰며 비교하는 방법도 함께 본다.
이 글에서 다루는 것
- "정리"와 "비교"를 나눠서 생각하는 사고 과정
- 왜 절반만 비교해도 되는가 (홀수 길이의 가운데 글자 포함)
- 이 문제가 왜 투 포인터에 잘 맞는지 (투 포인터 이론은 이 글 참고)
- Python · JavaScript · Java 코드 (알고리즘, 변수명, 주석 위치를 통일)
- 코드에 나온 문법: re.sub, replaceAll (JS의 g 플래그 포함), Java의 String.replaceAll
- 정리한 문자열을 만들지 않는 투 포인터 개선안, 그리고 언어별로 실제로 빨라지는지 직접 잰 결과
1. 문제
- 문제: 125. Valid Palindrome — https://leetcode.com/problems/valid-palindrome/
- 요약: 문자열에서 영문자와 숫자만 남기고 대소문자를 구분하지 않을 때, 앞에서 읽으나 뒤에서 읽으나 같은지 true / false로 답한다. 남는 글자가 하나도 없으면 회문으로 본다.
- 난이도: Easy
- 유형: 문자열 투 포인터
- 입력 규모: 문자열 길이는 최대 20만 자 수준이고, 화면에 찍을 수 있는 ASCII 문자로만 이뤄진다.
직접 만든 예시:
s = "Was it a car or a cat I saw?"  →  true   (정리하면 wasitacaroracatisaw)
s = "0P"                              →  false  (숫자 0과 문자 p는 서로 다른 글자)
s = ".,"                              →  true   (정리하면 빈 문자열)
2. 접근
2-1. 회문 판정은 "짝지어 비교"다
회문이면 앞에서 i번째 글자와 뒤에서 i번째 글자가 항상 같다. 그러니 양 끝에서 시작해 안쪽으로 한 쌍씩 비교하다가, 하나라도 다르면 바로 false를 돌려주면 된다.
2-2. 어려운 건 비교가 아니라 "지저분한 입력"이다
이 문제에서 짝지어 비교하는 부분은 쉽다. 손이 가는 건 입력에 섞인 공백·쉼표·물음표 같은 기호와 대소문자다. 비교하는 도중에 매번 "이 글자는 건너뛰어야 하나? 대문자는 어떻게 맞추지?"를 따지면 코드가 금방 복잡해진다.
그래서 일을 둘로 나눴다.
- 정리: 소문자로 통일하고, 영문자·숫자가 아닌 글자를 지운다.
- 비교: 정리된 문자열에서는 "글자 == 글자"만 본다.
예시로 보면 이렇게 된다.
"Was it a car or a cat I saw?"
  → 소문자로:   "was it a car or a cat i saw?"
  → 영숫자만:   "wasitacaroracatisaw"   (19자)
정리 단계의 순서에 함정이 하나 있다. 반드시 소문자 통일이 먼저이고 필터링이 나중이다. 이유는 5장에서 실제로 돌려 본 결과와 함께 다룬다.
2-3. 절반만 비교하면 충분한 이유
정리된 문자열의 길이를 size라고 하면, 앞에서 i번째 글자의 짝은 뒤에서 i번째 글자이고 인덱스로는 size - i - 1이다. 인덱스가 0부터 시작해서 -1이 붙는다.
s = "Xy-7, yx"를 따라가 보자. 정리하면 xy7yx이고 size = 5다.
| i | 앞 글자 (i) | 뒤 글자 (size - i - 1) | 같은가 |
| 0 | x | x | ✅ |
| 1 | y | y | ✅ |
size // 2 = 2이므로 2번 비교하고 끝난다. 가운데 7은 자기 자신과 짝이라 비교할 필요가 없다. 길이가 짝수(예: 4)면 정확히 2쌍, 홀수(예: 5)면 가운데 하나를 뺀 2쌍이라서, 둘 다 size // 2(내림)번이면 된다. 나머지 절반을 또 돌면 같은 쌍을 거꾸로 한 번 더 보는 셈이다.
불일치 예시 s = "0P"는 정리하면 0p이고, i = 0에서 0과 p가 달라 바로 false다.
이 접근의 대가도 미리 적어 둔다. 정리된 문자열을 통째로 새로 만든다는 점이다. 이 부분은 6장 리팩토링에서 다시 다룬다.
2-4. 왜 투 포인터인가
투 포인터는 위치를 가리키는 변수 두 개를 두고, 두 위치를 함께 움직이며 푸는 방식이다. 투 포인터 자체의 이론적인 설명은 이 글에서 확인하면 되고, 여기서는 이 문제와 연결되는 부분만 다룬다.
이 문제에 투 포인터가 잘 맞는 이유는 회문의 성질에 있다.
- 비교할 짝의 위치가 처음부터 정해져 있다. 앞에서 i번째와 뒤에서 i번째가 짝이다. 한쪽은 맨 앞에서, 다른 한쪽은 맨 뒤에서 출발하면 된다.
- 한 쌍을 볼 때마다 두 포인터가 한 칸씩 안쪽으로 온다. 그러다 둘이 만나거나 엇갈리면 모든 짝을 다 본 것이다. 2-3장에서 "절반만 보면 충분하다"고 한 것이 바로 이 종료 조건이다.
- 문자열은 양 끝에 O(1)로 접근할 수 있다. 인덱스로 바로 읽을 수 있어서, 뒤쪽 글자를 찾으려고 앞에서부터 세지 않아도 된다.
두 풀이 모두 투 포인터로 볼 수 있다. 다만 포인터를 드러내는 방식이 다르다.
| 풀이 | 왼쪽 포인터 | 오른쪽 포인터 | 오른쪽을 정하는 방법 |
| 1차 (정리 후 비교) | i | size - i - 1 | 왼쪽 i에서 계산한다 |
| 개선안 (6장) | left | right | 왼쪽과 따로 움직인다 |
1차 풀이는 정리된 문자열에서 오른쪽 포인터의 위치가 왼쪽 i만 알면 정해지니, 변수를 하나만 두고 size - i - 1로 계산했다.
개선안은 정리하지 않은 원문 위에서 곧바로 비교한다. 왼쪽 포인터는 왼쪽에 있는 기호를 건너뛰고, 오른쪽 포인터는 오른쪽에 있는 기호를 건너뛰는데, 양쪽에 기호가 몇 개씩 있는지는 서로 다르다. 예를 들어 s = "a!!b,a"에서는 왼쪽 포인터가 ! 두 개를, 오른쪽 포인터가 , 한 개를 건너뛴 뒤 가운데 b에서 만난다(직접 돌려서 확인했다). 그래서 두 포인터가 각자 따로 움직여야 하고, 이때부터 변수 두 개가 필요해진다. 이 문제에서 투 포인터가 "필요"해지는 지점이 여기다.
💡 투 포인터가 꼭 있어야 풀리는 문제는 아니다. 정리한 문자열을 t라고 하면, t를 뒤집어서 원본과 같은지 비교해도 풀린다. (Python t == t[::-1], JavaScript [...t].reverse().join(""), Java new StringBuilder(t).reverse(). 세 언어 모두 같은 테스트를 통과시켜 확인했다.) 다만 뒤집은 복사본이 하나 더 생기고(추가 메모리 O(n)), 전체를 뒤집고 나서야 비교가 시작된다. 6장의 개선안은 새 문자열 없이 첫 불일치에서 바로 멈춘다. 즉 이 문제에서 투 포인터는 필수 조건이 아니라, 회문의 대칭 구조에 잘 맞는 도구다.
3. 코드
세 언어 모두 알고리즘, 변수명(replace_string / replaceString, size, i), 주석 위치를 통일했고, 문법은 각 언어에서 쓰는 방식 그대로 썼다. 주석은 "무엇을"이 아니라 "왜"를 적었다.
🐍 Python
import re

class Solution:
    def isPalindrome(self, s: str) -> bool:
        """영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 True.

        s: 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
        """

        # 소문자 통일이 먼저, 필터링이 나중 — 순서를 뒤집으면 [^a-z0-9]가 대문자를 전부 지워 버린다
        replace_string = re.sub(r"[^a-z0-9]", "", s.lower())
        size = len(replace_string)
        # 절반만 돈다 — 양 끝에서 안쪽으로 짝지어 비교하니 나머지 절반은 중복 비교.
        # 홀수 길이의 가운데 글자는 자기 자신과 짝이라 비교하든 건너뛰든 결과가 같다
        for i in range(size // 2):
            # 앞에서 i번째의 짝은 뒤에서 i번째 — 인덱스가 0부터라 -1이 붙는다
            if replace_string[i] != replace_string[size - i -1]:
                return False

        # 불일치가 없었거나 비교할 쌍 자체가 없으면(빈 문자열·1글자) 회문으로 본다
        return True
🟨 JavaScript
/**
 * 영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 true.
 *
 * @param {string} s 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
 */
var isPalindrome = function(s) {
    // 소문자 통일이 먼저, 필터링이 나중 — 순서를 뒤집으면 [^a-z0-9]가 대문자를 전부 지워 버린다
    const replaceString = s.toLocaleLowerCase().replaceAll(/[^a-z0-9]/g, "");
    const size =replaceString.length;
    // 절반만 돈다 — 양 끝에서 안쪽으로 짝지어 비교하니 나머지 절반은 중복 비교.
    // 홀수 길이의 가운데 글자는 자기 자신과 짝이라 비교하든 건너뛰든 결과가 같다
    for (let i = 0; i < size / 2; i++) {
        // 앞에서 i번째의 짝은 뒤에서 i번째 — 인덱스가 0부터라 -1이 붙는다
        if(replaceString[i] != replaceString[size - i - 1]){
            return false;
        }
    }

    // 불일치가 없었거나 비교할 쌍 자체가 없으면(빈 문자열·1글자) 회문으로 본다
    return true
};
☕ Java
class Solution {
    /**
     * 영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 true.
     *
     * @param s 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
     */
    public boolean isPalindrome(String s) {

        // 소문자 통일이 먼저, 필터링이 나중 — 순서를 뒤집으면 [^a-z0-9]가 대문자를 전부 지워 버린다
        String replaceString = s.toLowerCase().replaceAll("[^a-z0-9]","");
        int size = replaceString.length();


        // 절반만 돈다 — 양 끝에서 안쪽으로 짝지어 비교하니 나머지 절반은 중복 비교.
        // 홀수 길이의 가운데 글자는 자기 자신과 짝이라 비교하든 건너뛰든 결과가 같다
        for (int i = 0; i < size / 2; i++) {
            // 앞에서 i번째의 짝은 뒤에서 i번째 — 인덱스가 0부터라 -1이 붙는다
            if(replaceString.charAt(i) != replaceString.charAt(size - i - 1)){
                return false;
            }
        }

        // 불일치가 없었거나 비교할 쌍 자체가 없으면(빈 문자열·1글자) 회문으로 본다
        return true;
    }
}
⚠️ 언어별로 갈리는 점 절반을 도는 반복문의 조건이 언어마다 조금 다르게 동작한다. Python size // 2와 Java size / 2(int끼리 나누기)는 내림이라 홀수 길이에서 가운데 글자를 건너뛴다. 반면 JavaScript의 size / 2는 실수 나눗셈이라 size = 5이면 2.5이고, i < 2.5가 되어 i = 2까지 돈다. 즉 가운데 글자를 자기 자신과 한 번 더 비교한다. 실제로 세어 보니 abcba에서 JS는 3번, Python은 2번 비교했다. 자기 자신과 비교하면 항상 같으니 결과는 바뀌지 않는다. 그래서 코드 주석을 "비교하든 건너뛰든 결과가 같다"로 썼다.
3-1. 코드에 나온 문법 정리
🐍 Python
re.sub(패턴, 바꿀 문자열, 대상)
패턴에 맞는 부분을 전부 다른 문자열로 바꿔서 새 문자열을 돌려준다. 여기서는 바꿀 문자열이 ""라서 "지우기"가 된다.
import re

re.sub(r"[^a-z0-9]", "", "ab, 7!")   # 'ab7'
- r"..."는 raw 문자열이다. 백슬래시를 이스케이프로 해석하지 않아서 정규식을 쓸 때 관례로 붙인다. 이 패턴에는 백슬래시가 없어서 없어도 동작하지만, 습관으로 붙이는 편이 안전하다.
- [^a-z0-9]에서 [...]는 문자 하나를 고르는 집합이고, 맨 앞의 ^는 부정이다. 즉 "소문자, 숫자가 아닌 글자 하나"에 맞는다.
- s.lower()도 원본을 바꾸지 않고 새 문자열을 돌려준다. 문자열은 불변이다.
range(size // 2)
//는 나눗셈의 몫(내림)이다. 5 // 2는 2, /를 쓰면 2.5가 되어 range에 넣을 수 없다(TypeError).
🟨 JavaScript
replaceAll(정규식, "")과 g 플래그
replaceAll에 정규식을 넘길 때는 g 플래그가 필수다. 빼면 예외가 난다.
'ab, 7!'.replaceAll(/[^a-z0-9]/g, "");  // 'ab7'
'ab, 7!'.replaceAll(/[^a-z0-9]/, "");
// TypeError: String.prototype.replaceAll called with a non-global RegExp argument
replace는 g가 없으면 첫 번째 일치만 바꾸지만, replaceAll은 아예 거부한다. 같은 결과를 주는 s.replace(/[^a-z0-9]/g, "")를 쓰는 코드도 많다.
toLocaleLowerCase()와 toLowerCase()
이 풀이에서는 둘의 결과가 같다. 다만 이름 그대로 앞의 것은 로케일을 고려하는 변환이고, 뒤의 것은 로케일과 무관하다. 5장에서 이 차이가 실제로 문제가 되는 경우를 다룬다.
replaceString[i], !=
- 문자열은 [i]로 글자 하나(길이 1짜리 문자열)를 읽을 수 있다.
- 글자끼리 비교하는 자리라 !=와 !==의 결과가 같다. 그래도 타입까지 비교하는 !==를 기본으로 쓰는 편이 좋다.
☕ Java
replaceAll(정규식, 바꿀 문자열)
String.replaceAll은 첫 인자를 정규식으로 해석하고, 바뀐 새 String을 돌려준다. String은 불변이라 s.toLowerCase()만 호출하고 결과를 받지 않으면 원본은 그대로다.
- 이 풀이는 toLowerCase() → replaceAll(...)을 이어 붙여서 결과 하나만 변수에 받는다.
- replaceAll은 호출할 때마다 내부에서 정규식을 컴파일한다. 이 문제는 한 번만 부르니 영향이 없지만, 반복문 안에서 여러 번 부른다면 Pattern을 미리 만들어 두는 게 낫다.
replaceString.charAt(i), size / 2
- charAt(i)는 char 하나를 돌려주고, char끼리는 !=로 비교해도 된다. (객체인 String을 !=로 비교하면 안 된다.)
- int / int는 정수 나눗셈이라 내림이다. 5 / 2는 2.
3-2. 세 언어 대조표
| 항목 | Python | JavaScript | Java |
| 소문자로 | s.lower() | s.toLocaleLowerCase() | s.toLowerCase() |
| 기호 지우기 | re.sub(r"[^a-z0-9]", "", ...) | .replaceAll(/[^a-z0-9]/g, "") | .replaceAll("[^a-z0-9]", "") |
| 길이 | len(x) | x.length | x.length() |
| 글자 읽기 | x[i] | x[i] | x.charAt(i) |
| 절반 | size // 2 | size / 2 (실수) | size / 2 (정수) |
| 홀수 길이의 가운데 | 건너뜀 | 자기 자신과 한 번 더 비교 | 건너뜀 |
4. 복잡도
n은 입력 문자열의 길이다.
| 단계 | 시간 | 공간 | 근거 |
| 정리 (소문자화 + 필터링) | O(n) | O(n) | 각각 문자열을 한 번씩 훑고, 결과를 새 문자열로 만든다 |
| 비교 | O(n) | O(1) | 최대 n / 2번 비교하고 추가 메모리는 변수 몇 개뿐이다 |
| 전체 | O(n) | O(n) | 정리 단계의 복사본이 공간을 결정한다 |
정리하는 동안 임시 문자열이 두 개(소문자본, 필터링한 결과) 생기지만 상수 배라서 O(n)으로 본다.
5. 흔한 실수
아래는 전부 글에 실린 코드를 일부러 고치거나 특수한 입력을 넣어서 실제로 돌려 본 결과다.
- 필터링을 소문자화보다 먼저 한다 — [^a-z0-9]에는 대문자가 들어 있지 않아서 대문자가 전부 지워진다. "ABC"를 먼저 필터링하면 빈 문자열이 되고, "Noon"은 N이 지워져 oon이 되어 false가 나온다(정답은 true).
- 정규식에서 숫자를 빠뜨린다 — [^a-z]로 쓰면 숫자가 전부 지워진다. "0P"는 p만 남아 true가 나온다(정답은 false).
- 짝의 인덱스에서 -1을 빠뜨린다 — size - i - 1이 아니라 size - i로 쓰면 첫 비교부터 범위를 벗어난다. 이때 실패하는 모양이 언어마다 다르다.
- Python: "aa"에서 IndexError
- Java: "aa"에서 StringIndexOutOfBoundsException
- JavaScript: 예외가 없다. 범위를 벗어난 읽기는 undefined를 돌려주고, "a" != undefined가 참이라 "aa"도 false, 심지어 글자 하나인 "a"도 false가 나온다. 예외 없이 답만 틀려서 셋 중 가장 찾기 어렵다.
- 글자가 하나도 안 남는 입력을 false로 처리한다 — ".,"는 정리하면 빈 문자열이고, 이 문제에서는 회문이다. 이 풀이는 반복문을 한 번도 돌지 않고 true로 빠져나오는 구조라서 자연스럽게 맞는다.
- toLowerCase()의 로케일 (Java) — toLowerCase()는 기본 로케일을 따른다. 터키어 로케일(tr_TR)에서는 I가 점 없는 ı로 바뀌고, 이 글자는 [a-z]가 아니라서 정규식에 지워진다. 실제로 "Iaba"(정답 false)가 true로 나왔다. 기본 로케일이 en_US인 일반적인 환경에서는 정상으로 나오니 제출에는 문제가 없겠지만, 알고 있으면 좋다. toLowerCase(Locale.ROOT)를 쓰면 로케일과 무관해진다.
- JS의 toLocaleLowerCase()는 이 환경에서는 재현되지 않았다. Node를 tr-TR 로케일로 띄워도 인자 없이 부르면 I가 i로 바뀌었다. 다만 'I'.toLocaleLowerCase('tr')처럼 로케일을 직접 넘기면 ı가 나온다. 굳이 로케일 함수를 쓸 이유가 없으니 toLowerCase()가 무난하다.
- replaceAll에 g 없는 정규식을 넘긴다 (JS) — 3-1장에서 본 것처럼 TypeError가 난다.
6. 리팩토링 노트
1차 풀이 → 왜 아쉬운가
1차 풀이는 정답이고 짧다. 아쉬운 점은 둘이다.
- 정리된 문자열을 통째로 새로 만든다. 추가 메모리가 O(n)이다. 그리고 첫 글자부터 짝이 안 맞는 입력이어도 정리(O(n))를 끝까지 먼저 해야 비교를 시작할 수 있다.
- 기호를 "지운다"는 방식이 정규식에 기대고 있다. 5장의 실수 1·2·6이 전부 정규식 주변에서 나왔다.
개선안: 정리 없이, 포인터로 건너뛰며 비교
문자열을 새로 만들지 않고 양 끝에 포인터 left, right를 세운다. 영숫자가 아닌 글자는 포인터를 움직여 건너뛰고, 소문자 맞추기는 비교하는 순간에만 한다. 포인터가 왜 두 개여야 하는지는 2-4장에서 다뤘다.
🐍 Python
class Solution:
    def isPalindrome(self, s: str) -> bool:
        """영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 True. 정리된 문자열을 따로 만들지 않고 양 끝 포인터로 바로 비교한다.

        s: 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
        """

        left, right = 0, len(s) - 1

        while left < right:
            # 영숫자가 아니면 건너뛴다 — 안쪽 while에도 left < right 가드가 필요하다
            # (기호만 있는 입력에서 포인터가 범위를 벗어난다)
            while left < right and not s[left].isalnum():
                left += 1
            while left < right and not s[right].isalnum():
                right -= 1

            # 대소문자는 비교하는 순간에만 맞춘다 — 문자열 전체를 소문자로 복사하지 않아도 된다
            if s[left].lower() != s[right].lower():
                return False

            left += 1
            right -= 1

        # 포인터가 만나거나 엇갈릴 때까지 불일치가 없었다면 회문 (빈 문자열·기호만 있는 입력 포함)
        return True
🟨 JavaScript
/**
 * 영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 true. 정리된 문자열을 따로 만들지 않고 양 끝 포인터로 바로 비교한다.
 *
 * @param {string} s 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
 */
var isPalindrome = function(s) {
    const isAlnum = (ch) => /[a-z0-9]/i.test(ch);

    let left = 0;
    let right = s.length - 1;

    while (left < right) {
        // 영숫자가 아니면 건너뛴다 — 안쪽 while에도 left < right 가드가 필요하다
        // (기호만 있는 입력에서 포인터가 범위를 벗어난다)
        while (left < right && !isAlnum(s[left])) {
            left++;
        }
        while (left < right && !isAlnum(s[right])) {
            right--;
        }

        // 대소문자는 비교하는 순간에만 맞춘다 — 문자열 전체를 소문자로 복사하지 않아도 된다
        if (s[left].toLowerCase() !== s[right].toLowerCase()) {
            return false;
        }

        left++;
        right--;
    }

    // 포인터가 만나거나 엇갈릴 때까지 불일치가 없었다면 회문 (빈 문자열·기호만 있는 입력 포함)
    return true;
};
☕ Java
class Solution {
    /**
     * 영문자·숫자만 남겼을 때 앞뒤로 읽어도 같으면 true. 정리된 문자열을 따로 만들지 않고 양 끝 포인터로 바로 비교한다.
     *
     * @param s 검사할 문자열 (공백·기호·대소문자가 섞여 있어도 됨)
     */
    public boolean isPalindrome(String s) {

        int left = 0;
        int right = s.length() - 1;

        while (left < right) {
            // 영숫자가 아니면 건너뛴다 — 안쪽 while에도 left < right 가드가 필요하다
            // (기호만 있는 입력에서 포인터가 범위를 벗어난다)
            while (left < right && !Character.isLetterOrDigit(s.charAt(left))) {
                left++;
            }
            while (left < right && !Character.isLetterOrDigit(s.charAt(right))) {
                right--;
            }

            // 대소문자는 비교하는 순간에만 맞춘다 — 문자열 전체를 소문자로 복사하지 않아도 된다
            if (Character.toLowerCase(s.charAt(left)) != Character.toLowerCase(s.charAt(right))) {
                return false;
            }

            left++;
            right--;
        }

        // 포인터가 만나거나 엇갈릴 때까지 불일치가 없었다면 회문 (빈 문자열·기호만 있는 입력 포함)
        return true;
    }
}
안쪽 while의 left < right 가드가 이 방식의 새 함정이다. 이 가드를 빼고 Python으로 돌려 보니 "..."와 ".," 같은 기호만 있는 입력에서 IndexError가 났다. 건너뛰다가 포인터가 문자열 끝을 넘어가기 때문이다.
문법 몇 가지:
- Python str.isalnum(), Java Character.isLetterOrDigit()은 유니코드 글자(한글, 악센트 문자 등)도 참으로 판단한다. 이 문제의 입력은 ASCII뿐이라 1차 풀이와 결과가 같지만, 입력 범위가 넓어지면 달라진다. JS는 내장이 없어서 /[a-z0-9]/i.test(ch)로 ASCII만 확인했다.
- Java Character.toLowerCase(char)는 로케일과 무관하다. 그래서 5장의 터키어 로케일 함정을 피한다. tr_TR로 띄워서 "Iaba"가 false로 나오는 것을 확인했다.
- 변수명은 left, right로 세 언어를 통일했다.
실제로 빨라지나?
직접 재 봤다. 입력은 약 19.9만 자(제약의 최대 수준)이고, 기호와 대소문자가 섞여 있다. 각 조건에서 중앙값을 구했고, 이걸 두 번 반복해서 나온 범위다.
| 입력 | 언어 | 1차 (정리 후 비교) | 개선안 (투 포인터) |
| 회문 (끝까지 비교) | Python | 19.6 ~ 21.0ms | 23.1 ~ 43.2ms |
| 회문 (끝까지 비교) | JavaScript | 6.9 ~ 9.9ms | 10.1 ~ 10.2ms |
| 회문 (끝까지 비교) | Java | 5.0 ~ 6.2ms | 1.1ms |
| 첫 글자 쌍부터 불일치 | Python | 12.6 ~ 13.6ms | 0.001ms |
| 첫 글자 쌍부터 불일치 | JavaScript | 6.0 ~ 9.0ms | 1µs 미만 |
| 첫 글자 쌍부터 불일치 | Java | 4.1 ~ 4.2ms | 0.001ms |
측정의 한계를 먼저 밝힌다. 한 대의 실행 환경에서 잰 값이고, Python 개선안은 한 번의 중앙값(43ms)이 최솟값(22ms)의 두 배에 가까울 만큼 흔들렸다. Java와 JS는 JIT 워밍업의 영향도 있다. 그래서 절대 수치보다 경향만 봐야 한다.
- 불일치가 앞에서 나는 입력은 세 언어 모두 개선안이 압도적이다. 정리 비용을 아예 치르지 않기 때문이다.
- 끝까지 비교해야 하는 입력은 언어마다 갈렸다. Java는 개선안이 약 5배 빨랐지만, JavaScript는 비슷하거나 약간 느렸고, Python은 같거나 더 느렸다.
- Python과 JS가 느린 이유는 측정하지 않았다. 1차 풀이의 정규식과 문자열 함수는 엔진 내부에서 한 번에 처리되는 반면, 개선안은 글자마다 인터프리터 수준에서 함수 호출(isalnum(), lower(), 정규식 test)을 한다는 점이 원인일 것이라고 추정할 뿐이다.
- 이 제약에서는 어느 쪽이든 수십 ms 안에 끝난다. 채점에서는 차이가 의미 없다.
얻은 것과 잃은 것
- 얻은 것: 추가 메모리가 O(1)이 된다. 불일치가 앞에서 나면 곧바로 끝난다. Java에서는 로케일 함정이 사라지고, 정규식 관련 실수(순서, 숫자 누락, g 플래그)가 없어진다.
- 잃은 것: 코드가 길어진다. 안쪽 while 가드라는 새 함정이 생긴다. 정리 한 줄이 "기호와 대소문자를 걷어낸다"는 의도를 바로 보여 주던 가독성도 줄어든다. 그리고 최악의 입력에서 Python과 JS는 더 빨라지지 않았다.
- 결론: 1차 풀이가 틀린 접근은 아니다. 짧고 의도가 잘 보여서 처음 풀 때는 이쪽이 낫다. "추가 메모리를 줄일 수 있나?"라는 후속 질문이 나오면 개선안으로 넘어가면 된다.
7. 마무리
- 회문 판정의 핵심은 양 끝에서 안쪽으로 짝지어 비교하는 것이고, 절반만 보면 충분하다.
- 짝이 양 끝에 있어서 이 문제는 투 포인터와 잘 맞는다. 정리하지 않은 원문 위에서 곧바로 비교하려면 왼쪽과 오른쪽이 서로 다른 만큼 기호를 건너뛰어야 해서 두 포인터가 따로 움직여야 한다. 다만 필수는 아니고, 뒤집어서 비교하는 풀이도 가능하다. 투 포인터의 이론은 이 글을 참고한다.
- 이 문제의 실질적인 난이도는 비교가 아니라 입력 정리다. 정리를 먼저 끝내는 방식(O(n) 메모리)과 비교하면서 건너뛰는 방식(O(1) 메모리)이 있다.
- 정리를 먼저 할 때는 소문자 통일 → 필터링 순서, 정규식의 숫자 포함 여부, 짝의 인덱스 -1을 확인한다.
- 투 포인터가 이론상 항상 빠른 건 아니다. Java에서는 빨랐지만 Python·JS에서는 최악의 입력에서 이득이 없었다.
'알고리즘 > Leetcode' 카테고리의 다른 글
| [Leetcode]704. Binary Search (0) | 2026.10.02 |
|---|---|
| [Leetcode]347. Top K Frequent Elements (0) | 2026.09.30 |
| [Leetcode]121. Best Time to Buy and Sell Stock (0) | 2026.09.29 |
| [Leetcode]49. Group Anagrams (0) | 2026.09.22 |
| [Leetcode]2894. Divisible and Non-divisible Sums Difference (2) | 2025.07.31 |
